数据库索引不是免费的提速券
2026-10-24 19:18:01
作者:
fawen
上周帮朋友排查线上慢查询,翻到执行计划的那一刻,我差点把键盘掀了——他给一张日增30万行的订单表,给三个普通业务字段全加了单列索引,以为能靠这个把查询拉到毫秒级,结果写请求卡到超时。
谁都被教过,查询慢就加索引。但没人跟你说透,加进去的每一条索引,都是要实打实占资源的。
索引不是加得越多越好
很多人对索引的认知还停留在“查询加速工具”,完全忘了它的另一面——每多建一条索引,所有写操作的成本就会同步涨一截。
你往表里插一条数据,数据库要做的事不只是把行数据写到对应的表空间页里。所有关联的索引,都要同步完成新键值的插入、节点排序,碰到页填满了还要做分裂,旧页的合并清理更是躲不掉。
刚才那个朋友的场景,三个单列索引,每次插入一条订单,就要同时维护三棵独立的B+树。本来毫秒级就能完成的写操作,硬生生拖到800毫秒。
谁遭得住。
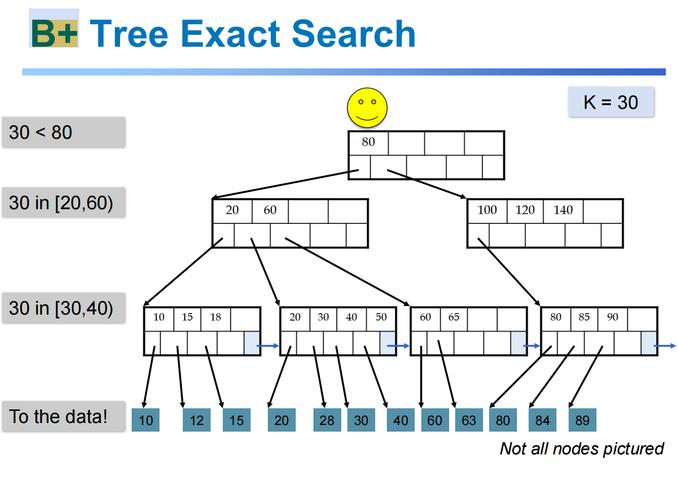 数据库B+树索引分裂过程示意图
别觉得这点开销是毛毛雨。你算,日增30万行,每一行多三次索引维护,一天下来多跑多少随机磁盘IO?本来半夜半小时能跑完的批量对账任务,现在要卡三个小时,数据库连接池直接被占满,第二天早高峰的用户请求全在排队。
更别说索引本身占的存储空间。单表的数据可能才10G,三个索引加起来占了8G,本来数据库的内存缓冲池能存下热数据的1/3,现在一半内存都被索引占了,连带着热数据的命中率都往下掉。
最容易踩的联合索引顺序坑
我见过太多人,联合索引建完就扔在那,根本不管字段顺序。
真的,每次看到建索引的SQL日志,我都想把执行计划导出来给当事人看看。之前碰到过一个场景,要按“用户ID+订单状态+创建时间”查某个用户最近的已支付订单。有人上来就按创建时间、订单状态、用户ID的顺序建了联合索引,觉得创建时间是排序字段,放第一个查的时候快。
结果呢?查询的where条件先筛用户ID,根本匹配不上索引的第一个字段,直接走了全表扫描。
说白了,联合索引的排序逻辑是有严格优先级的:先按第一个字段排,第一个字段值相同的情况下,再按第二个字段排,第二个字段值相同,才轮到第三个。索引的顺序不是你觉得哪个字段常用就放前面,是要跟着查询的筛选逻辑走的。把最常用来做等值筛选的字段放最后,那这个索引基本等于白建。
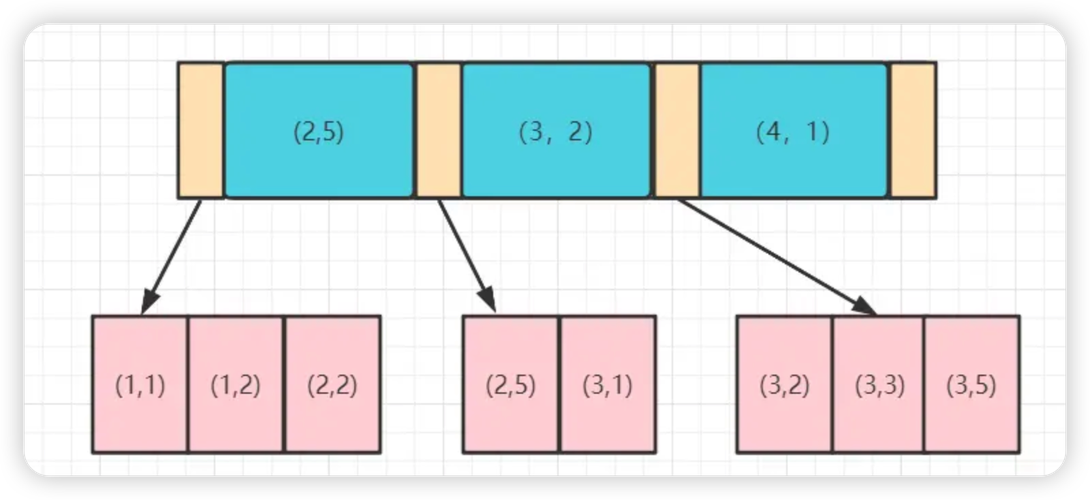 联合索引最左匹配规则示意图
很多人学了个最左匹配的概念,就觉得只要第一个字段对了就万事大吉。实际上如果你查询的时候跳过中间的状态字段,直接从用户ID跳到创建时间,索引也只能用到第一个字段的排序,后面的字段根本走不上。查出来的数据量一大,还是要花大量时间做内存排序。
那些看起来聪明的索引,其实在偷性能
还有人学了个覆盖索引,就恨不得把所有查询用到的字段全塞到联合索引里,觉得这样连回表都不用,直接查索引树就能拿到结果,速度肯定快。
但没人算过这笔账。索引树的节点大小是固定的,你塞的字段越多,单个节点能存的键值就越少,整棵树的高度就会往上窜。本来3次磁盘IO能查到的结果,现在要6次,提速没看到,磁盘IO先翻了倍。
我之前碰到过更夸张的,给长度上百的商品标题字段加全字段索引。那索引树长得快赶上表本身的大小了,每次写商品信息,光维护索引就要花掉原来三倍的时间。查询的时候因为索引太长,缓存命中率低得可怜,根本没比全表扫描快多少。
这事没那么玄。索引本质上就是拿空间换时间的买卖,你拿的空间多了,时间成本自然会在别的地方找补回来。
后来帮那个朋友优化的时候,我把他之前加的三个冗余单列索引全删了,换成一个按“用户ID+订单状态+创建时间”顺序建的联合索引,刚好覆盖了他常用的几个查询字段。上线那天,写请求的平均耗时直接降了60%,查询速度反而比之前更快——毕竟之前三个单列索引,优化器经常选错,还要回表拿数据,现在直接从索引里就能取到所有需要的字段。
很多人聊数据库索引,总喜欢把它讲成一套玄乎的优化玄学。其实根本不是。你只要记住,每建一条索引,都要对着自己的业务场景算两笔账:查询的时候能省多少时间,写的时候要多花多少代价。别听别人说什么“最佳实践”就照搬,你的表多大,你的查询是什么样的,只有你自己清楚。
哦对,还有,别上来就给所有字段加索引,真的会出事。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
数据库索引不是免费的提速券
文章链接:https://itcdj.com/it/84.html